
Wenn eine gute Unterhaltung aus dem Tritt kommt
Der erste Vorschlag ist brauchbar. Eine Rückfrage bringt die gewünschte Verbesserung. Nach mehreren Korrekturen taucht jedoch ein Fehler wieder auf, der längst behoben schien. Eine wichtige Anforderung fehlt plötzlich, während die KI ausführlich erklärt, sie habe alles berücksichtigt.
So könnte eine frustrierende Arbeitssitzung aussehen. Wer eine Anwendung fertigstellen möchte, hat wenig davon, dieselbe Vorgabe zum fünften Mal zu wiederholen.
Die naheliegende Frage lautet: Ist das Modell schlechter geworden? Wurde etwas verändert? Oder ist die Unterhaltung inzwischen so unübersichtlich, dass entscheidende Informationen untergehen?
Qualitätsprobleme können real sein. Ihre Ursache lässt sich aber nicht allein daran erkennen, wie enttäuschend eine Antwort ausfällt.
Was die viel zitierte Zahl von 39 Prozent tatsächlich bedeutet
Die Untersuchung „LLMs Get Lost In Multi-Turn Conversation“ wurde erstmals am 9. Mai 2025 veröffentlicht und wird von Microsoft Research als Beitrag zur ICLR 2026 geführt. Die Autoren verglichen vollständig formulierte Einzelaufträge mit Gesprächen, in denen die benötigten Informationen schrittweise mitgeteilt wurden. Über sechs Aufgabenbereiche hinweg ermittelten sie einen durchschnittlichen Leistungsrückgang von 39 Prozent in der untersuchten Mehrfachdialog-Situation. Ausgewertet wurden mehr als 200.000 simulierte Gespräche. [1]
Das ist nicht gleichbedeutend mit der Behauptung, jede längere Unterhaltung verliere zwangsläufig 39 Prozent ihrer Genauigkeit. Es handelt sich auch nicht um einen allgemeinen Messwert für die heute verfügbaren Modelle.
Ein wesentliches Problem der untersuchten Systeme: Sie trafen früh Annahmen und hielten anschließend zu stark an ihren ersten Lösungsversuchen fest. Die Untersuchung beweist weder, dass Sicherheitsvorgaben die Ursache waren, noch dass Anbieter ihre Modelle absichtlich verschlechterten. [1]
Für die Praxis ist die Unterscheidung wichtig. Eine verfahrene Unterhaltung braucht möglicherweise einen bereinigten Arbeitsauftrag – nicht noch eine weitere Korrektur derselben falschen Ausgangsannahme.
Der Arbeitskontext besteht aus mehr als der letzten Nachricht
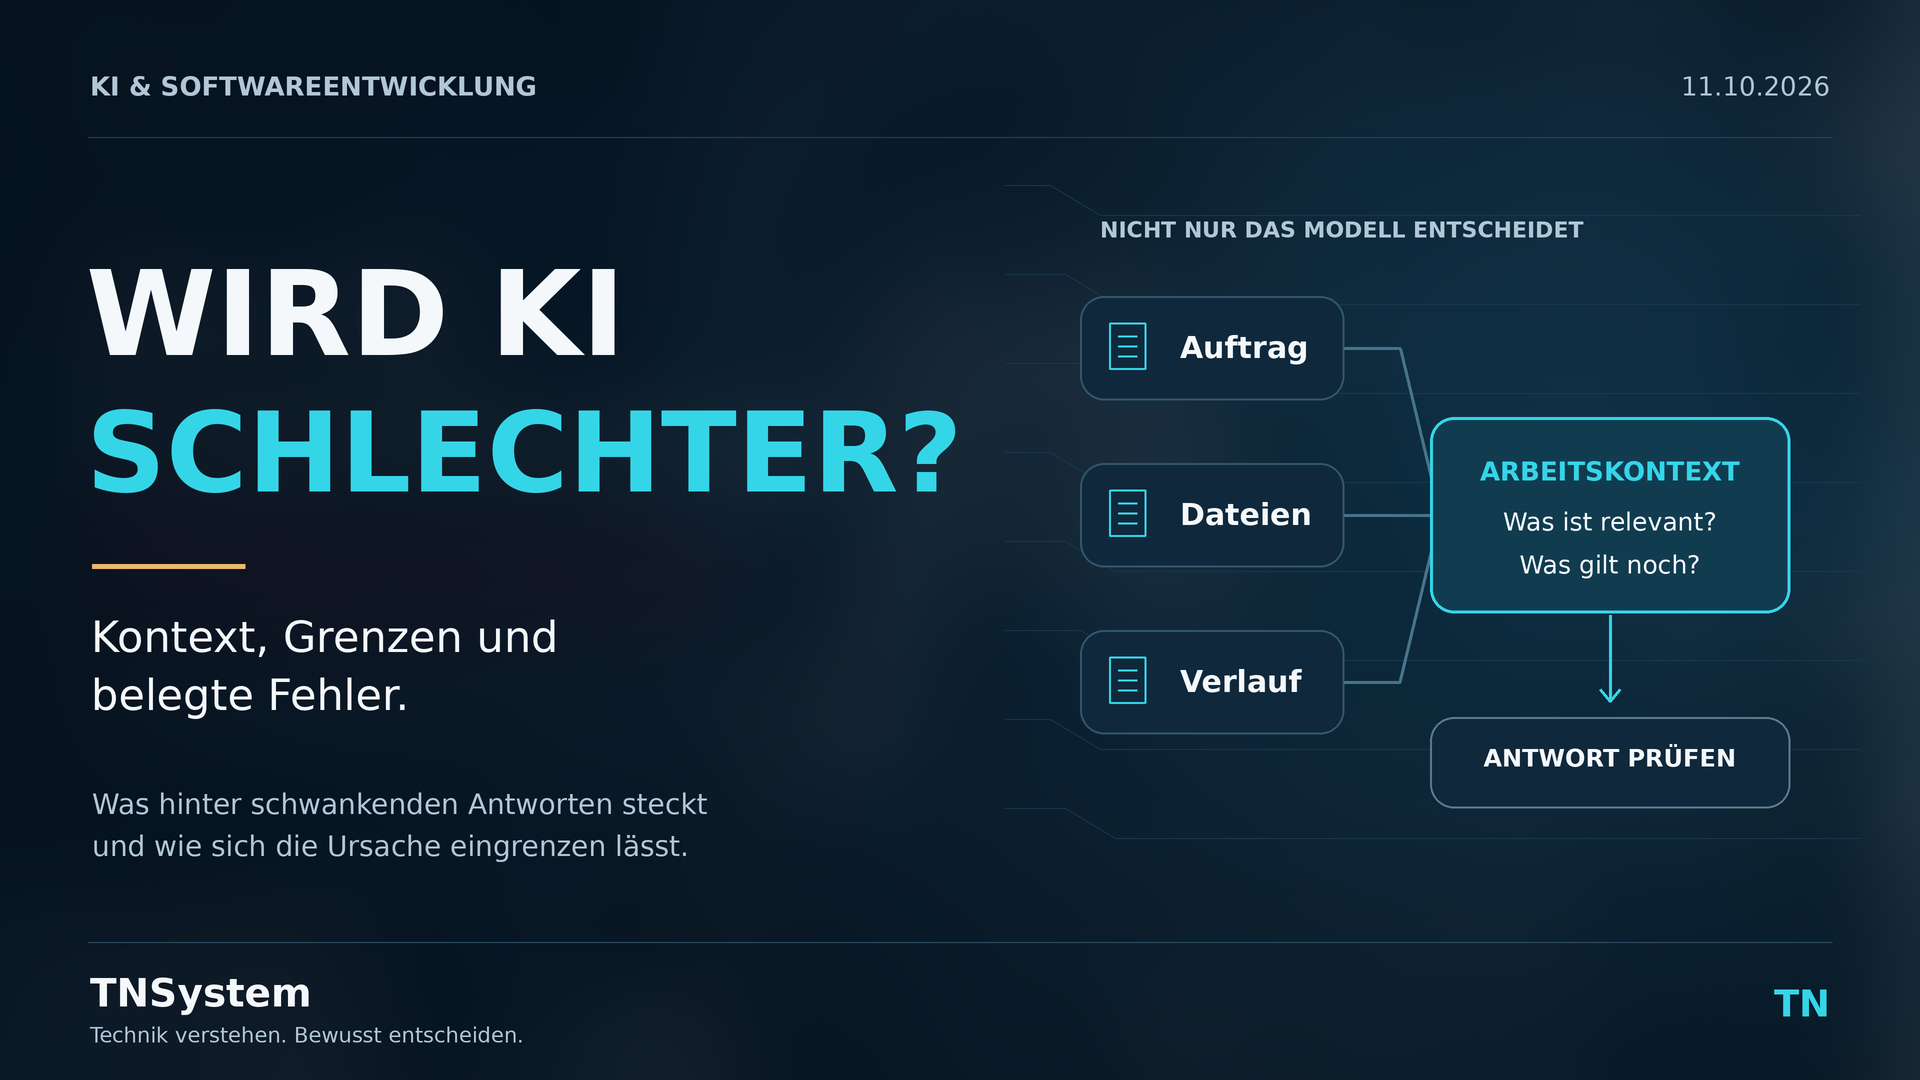
Bei einem KI-Agenten können neben der aktuellen Frage auch Systemanweisungen, Gesprächsverlauf, Dateiausschnitte, Werkzeugbeschreibungen und Ergebnisse vorheriger Arbeitsschritte berücksichtigt werden. Anthropic erläutert diesen Zusammenhang in seinem Beitrag zum Context Engineering vom 29. September 2025. Das Unternehmen beschreibt Kontext dabei als begrenzte Ressource, die gezielt zusammengestellt werden sollte. [2]
Der häufig verwendete Ausdruck Context Bloat bezeichnet einen aufgeblähten Arbeitskontext. Gemeint ist nicht einfach nur „viel Text“, sondern auch unnötige, veraltete oder miteinander konkurrierende Informationen.
Ein Beispiel: Zu Beginn soll eine Anwendung eine lokale Datei verwenden. Später fällt die Entscheidung für eine Datenbank. Danach werden beide Varianten noch mehrfach diskutiert. Wird nicht klar festgehalten, welche Entscheidung verbindlich ist, bleibt der Verlauf als Arbeitsgrundlage widersprüchlich.
Meine Konsequenz daraus wäre nicht, möglichst wenig zu erklären. Die KI braucht die richtigen Informationen – nicht wahllos alle Informationen, die im Projekt irgendwann einmal aufgetaucht sind.
Auch ein neues Gespräch hilft nur, wenn die notwendigen Entscheidungen und aktuellen Dateien mitgegeben werden. Ohne diese Übergabe beginnt lediglich die nächste Runde mit unvollständigen Angaben.
Reale Verschlechterungen sind dokumentiert
Es wäre ebenso falsch, sämtliche Beschwerden auf ungeschickte Eingaben der Nutzer zurückzuführen.
Anthropic veröffentlichte am 23. April 2026 eine Untersuchung zu Qualitätsproblemen in Claude Code, dem Claude Agent SDK und Claude Cowork. Der Anbieter beschrieb drei Ursachen: eine zeitweise abgesenkte Voreinstellung für den Denkaufwand, einen Fehler beim Umgang mit früheren Überlegungen in längeren Sitzungen und eine Systemanweisung zur Kürzung von Antworten, die zusammen mit anderen Änderungen die Programmierqualität beeinträchtigte. [3]
Nach Anbieterangaben waren die Probleme bis zum 20. April 2026 behoben. Die API war laut Bericht nicht betroffen. Das ist eine historische Fehleranalyse und keine Feststellung, dass dieselben Probleme heute unverändert bestehen. [3]
Der Fall zeigt trotzdem etwas Entscheidendes: Nicht nur das zugrunde liegende Modell beeinflusst das Ergebnis. Auch die Anwendung, ihre Einstellungen und ihre Verwaltung des Gesprächsverlaufs können einen Unterschied machen.
Die Aussage „Das kann nicht sein, das Modell wurde gar nicht verändert“ wäre deshalb als Antwort auf eine nachvollziehbare Beschwerde zu einfach.
Ausfälle und Nutzungslimits sind eine andere Art von Problem
Wenn ein Dienst langsam reagiert, Anfragen abbricht oder zeitweise nicht erreichbar ist, betrifft das zunächst seine Verfügbarkeit.
OpenAIs API-Dokumentation unterscheidet Fehler durch Nutzungslimits von Serverfehlern und zeitweiser Überlastung. Ein Fehler oder eine abgewiesene Anfrage ist daher für sich genommen kein Nachweis schlechterer fachlicher Antworten. [6]
Auch ein Rate-Limit ist zunächst eine Nutzungsbegrenzung. Die OpenAI-Dokumentation beschreibt beispielsweise Grenzen für Anfragen oder verarbeitete Tokens innerhalb eines Zeitraums. Daraus folgt nicht automatisch, dass eine beantwortete Anfrage heimlich von einem schwächeren Modell bearbeitet wurde. [5]
Für die Fehlersuche sollten deshalb unterschiedliche Beobachtungen getrennt werden:
Die Anfrage bricht ab oder wird wegen eines Limits abgewiesen.: Dienststatus, Fehlermeldung und verfügbare Kontingente.
Antworten kommen, berücksichtigen aber frühere Entscheidungen falsch.: Arbeitskontext, widersprüchliche Vorgaben und aktueller Projektstand.
Derselbe Auftrag liefert nach einer Produktänderung andere Ergebnisse.: Modellwahl, Denkaufwand, Werkzeuge und Anwendungsversion.
Ein Agent behauptet, Dateien geändert zu haben, das Ergebnis fehlt aber.: Tatsächliche Dateien, Werkzeugausgaben und Ausführungsprotokolle.
Die Tabelle ist eine Orientierung für die Untersuchung, kein Verfahren, das jede Ursache eindeutig feststellen kann.
Wird unter demselben Namen heimlich ein kleineres Modell verwendet?
Unterschiedliche Modelle und Leistungsstufen gibt es. OpenAIs offizielle Dokumentation beschreibt unterschiedliche Modelle und Denkstufen ausdrücklich. Verfügbarkeit und Werkzeuge hängen unter anderem von Produkt und Modellversion ab. Die Dokumentation wurde am 11. Oktober 2026 geprüft. [5]
Eine dokumentierte Produktauswahl ist jedoch etwas anderes als die Behauptung, Anbieter würden bei hoher Auslastung grundsätzlich heimlich auf schlechtere Modelle umschalten.
Für diese pauschale Behauptung liefern die hier geprüften Quellen keinen belastbaren Nachweis. Auch eine vermeintlich stärkere Quantisierung lässt sich nicht allein aus einer ungewöhnlichen Antwort ableiten.
Anthropic erklärte in seinem Fehlerbericht vom 17. September 2025 ausdrücklich, die damaligen Qualitätsprobleme seien auf Infrastrukturfehler zurückzuführen gewesen und nicht auf eine absichtliche Verringerung der Modellqualität bei hoher Nachfrage. Der Bericht beschreibt unter anderem fehlerhaftes Routing und Probleme bei der Berechnung der Ausgabe. Das ist die Erklärung des Anbieters, keine unabhängige Prüfung sämtlicher interner Systeme. [4]
Kritik an der Qualität ist berechtigt. Eine Erklärung für die Ursache braucht trotzdem eigene Belege.
Die Entwicklerstimmung ist nicht einheitlich
Einzelberichte in Foren können auf Probleme aufmerksam machen. Sie zeigen aber nicht automatisch, wie häufig ein Fehler auftritt oder wodurch er verursacht wurde.
Auch die aktuelle Stack Overflow Developer Survey 2026, geprüft am 11. Oktober 2026, ergibt kein ausschließlich negatives Bild: Positive Einstellungen zu KI überwiegen. Zugleich geben 48 Prozent der Antwortenden auf die Vertrauensfrage an, KI-Ausgaben dann zu vertrauen, wenn sie diese leicht überprüfen können. [7]
Das passt für mich zu einer nüchternen Nutzung: Ein Werkzeug kann hilfreich sein, ohne dass ihm jede Aufgabe ungeprüft übertragen wird.
Unzufriedenheit und Nutzen schließen einander nicht aus. Eine KI kann bei Routinearbeit entlasten und bei einer schwierigen Änderung trotzdem mehr Betreuung benötigen, als zunächst erwartet wurde.
Den gültigen Stand festhalten
Bevor ich eine weitere Korrektur anfordere, würde ich den Auftrag neu ordnen: Was soll erreicht werden? Welche Entscheidungen gelten? Welche Variante wurde verworfen? Welche Dateien sind aktuell?
Eine solche Übergabe könnte beispielsweise lauten:
Verbindlicher Stand: Die Anwendung verwendet die vorhandene Datenbank. Die zuvor diskutierte lokale Dateispeicherung wird nicht umgesetzt. Geändert werden soll ausschließlich die Suchfunktion. Die Berechtigungsprüfung bleibt unverändert. Offene Fragen bitte vor Änderungen benennen.
Das ist ein Arbeitsbeispiel, keine Garantie für eine fehlerfreie Antwort. Es schafft aber eine wesentlich klarere Grundlage als der Hinweis „Mach es jetzt endlich richtig“.
Mit gleichen Bedingungen vergleichen
Bei einem begründeten Verdacht auf Qualitätsverlust würde ich einige typische Aufgaben mit erwarteten Ergebnissen festhalten. Danach lassen sich alter Verlauf und neuer, bereinigter Verlauf vergleichen.
Dabei sollten Modell, verfügbare Werkzeuge und Einstellungen möglichst gleich bleiben. Sonst ist unklar, welche Veränderung den Unterschied verursacht hat.
Eine einzelne bessere Antwort beweist noch keinen dauerhaften Vorteil. Mehrere vergleichbare Versuche geben einen brauchbareren Eindruck.
Fehler melden, ohne vertrauliche Daten offenzulegen
Eine hilfreiche Fehlermeldung enthält den Zeitpunkt, die verwendete Anwendung, den erwarteten Ablauf und das tatsächliche Ergebnis. Bei Entwicklungswerkzeugen können Versionsangaben und vorhandene Anfragekennungen die Untersuchung erleichtern.
Kundendaten, Zugangsschlüssel und interne Unterlagen gehören nicht ungeprüft in einen öffentlichen Fehlerbericht. Für eine erste Meldung würde ich ein möglichst kleines, bereinigtes Beispiel erstellen.
Mein Fazit: Den Fehler ernst nehmen, die Erklärung prüfen
Wenn eine KI Anforderungen verliert oder dieselben Fehler wiederholt, ist der Ärger verständlich. Nutzer müssen ein bezahltes Werkzeug nicht schönreden.
Genauso wenig hilft es, jede enttäuschende Antwort sofort als Beweis einer geheimen Drosselung zu behandeln. Dokumentierte Produktfehler, unübersichtlicher Kontext, veränderte Einstellungen und Dienststörungen sind unterschiedliche Sachverhalte.
Ich erwarte von den Anbietern nachvollziehbare Informationen über Änderungen und eine ernsthafte Untersuchung reproduzierbarer Beschwerden. Bei der eigenen Arbeit würde ich gleichzeitig darauf achten, dass Aufgaben, Entscheidungen und Ergebnisse überprüfbar bleiben.
Die entscheidende Frage ist nicht nur, ob eine KI gerade schlechter wirkt. Sondern unter welchen Bedingungen sie scheitert – und was sich daran konkret ändern lässt.
Einordnung und Recherche
Recherchestand: 11. Oktober 2026. Historische Fehlerberichte und Studien sind nicht unverändert auf aktuelle Modelle oder Konten übertragbar. Keine eigenen Vergleichsmessungen und kein Nachweis allgemein praktizierter absichtlicher Drosselung. Allgemeine technische Orientierung, keine individuelle Rechtsberatung.
Quellen und weiterführende Informationen
[1] Philippe Laban, Hiroaki Hayashi, Yingbo Zhou und Jennifer Neville: „LLMs Get Lost In Multi-Turn Conversation“
Quelle lesen ↗
[1] Philippe Laban, Hiroaki Hayashi, Yingbo Zhou und Jennifer Neville: „LLMs Get Lost In Multi-Turn Conversation“
Quelle lesen ↗
[2] Anthropic: „Effective context engineering for AI agents“
Quelle lesen ↗
[3] Anthropic: „An update on recent Claude Code quality reports“
Quelle lesen ↗
[4] Anthropic: „A postmortem of three recent issues“
Quelle lesen ↗
[5] OpenAI: Modelle, Denkstufen und API-Nutzungslimits
Quelle lesen ↗
[5] OpenAI: Modelle, Denkstufen und API-Nutzungslimits
Quelle lesen ↗
[6] OpenAI: API-Fehlercodes – Nutzungslimits und Überlastung
Quelle lesen ↗
[7] Stack Overflow Developer Survey 2026: „AI“
Quelle lesen ↗