
Von der hilfreichen Antwort zum verbundenen Arbeitsablauf
Eine KI formuliert einen Brief, erklärt einen Programmfehler oder fasst Unterlagen zusammen. Das ist hilfreich. Interessanter wird es, wenn sie die benötigten Informationen selbst zusammenträgt, mit Anwendungen arbeitet und aus einem Auftrag mehrere zusammenhängende Arbeitsschritte macht.
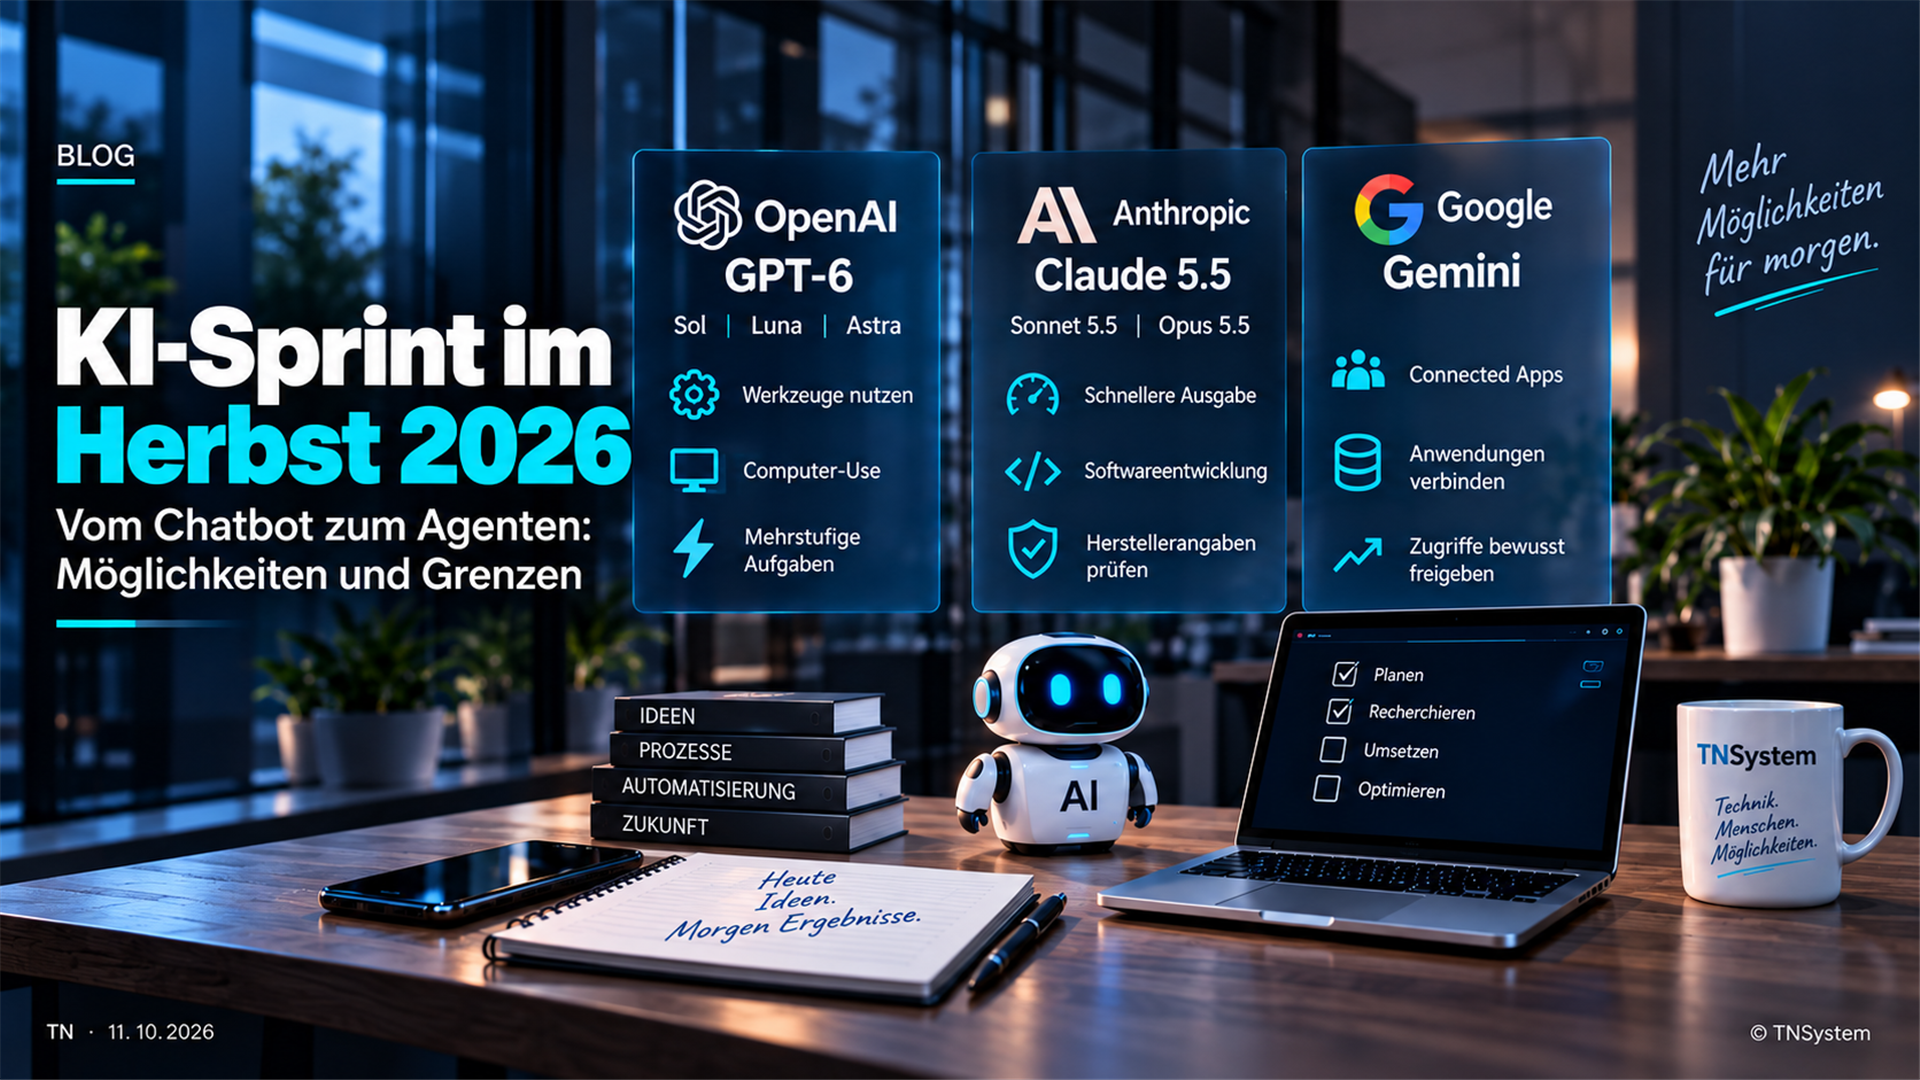
Genau in diese Richtung gehen die jüngsten Veröffentlichungen von OpenAI, Anthropic und Google: Neben besseren Antworten stehen die Bedienung von Software, die Bearbeitung längerer Aufgaben und die Verbindung mit anderen Anwendungen im Mittelpunkt. Die Ankündigungen aus September und Oktober 2026 zeigen diese Entwicklung deutlich. [1][2][4][8]
Für mich ist das der spannendere Teil des aktuellen Wettbewerbs. Nicht jede neue Versionsnummer verändert den Arbeitsalltag. Ein Werkzeug, das einen klar umrissenen Vorgang zuverlässig vorbereitet oder erledigt, kann dagegen einen echten Unterschied machen.
Der Maßstab sollte deshalb nicht lauten: Wie beeindruckend klingt die Vorführung? Sondern: Was funktioniert anschließend unter unseren eigenen Bedingungen?
OpenAI: Die GPT-6-Familie kam in mehreren Schritten
Bei den Veröffentlichungsdaten lohnt sich ein genauer Blick. Die GPT-6-Generation startete nicht geschlossen am DevDay.
OpenAI stellte GPT-6 Astra am 3. September 2026 vor. Am 22. September folgten GPT-6 Sol und GPT-6 Luna. Zum DevDay am 29. September 2026 kam mit GPT-6.1 Sol bereits eine weitere Ausbaustufe hinzu. Diese Reihenfolge geht aus dem offiziellen API-Changelog hervor. [1]
Bei Astra stellt OpenAI insbesondere die Computernutzung, Softwareentwicklung und mehrstufige Wissensarbeit heraus. Das Modell soll beispielsweise mit Anwendungen arbeiten, Informationen auswerten und Dokumente erstellen können. Das sind Herstellerangaben zu den vorgesehenen Fähigkeiten, keine Zusage, dass jeder beliebige Auftrag ohne Fehler abgeschlossen wird. [1]
GPT-6.1 Sol soll anspruchsvolle Aufgaben günstiger zugänglich machen. Für Standard-API-Anfragen im Kurzkontext mit höchstens 272.000 Eingabetokens nennt OpenAI Preise von 2 US-Dollar je Million Eingabetokens und 10 US-Dollar je Million Ausgabetokens. Für Astra werden in derselben Gegenüberstellung 10 beziehungsweise 50 US-Dollar genannt. Langkontext, zwischengespeicherte Eingaben, Cache-Schreibvorgänge und andere Verarbeitungsklassen haben eigene Preise; Werkzeugkosten können hinzukommen. Die Angaben sind keine ChatGPT-Abonnementpreise. [12]
Tokens sind die Einheiten, in denen das Modell Inhalte verarbeitet und die Nutzung abgerechnet wird. Sie entsprechen nicht einfach einer festen Anzahl vollständiger Wörter.
Für Entwickler ist dieser Preisunterschied interessant. Er beantwortet aber noch nicht, welches Modell eine Aufgabe insgesamt wirtschaftlicher erledigt. Dafür müssten auch die benötigte Verarbeitungsmenge, Wiederholungen und die anschließende Prüfung berücksichtigt werden.
Claude 5.5: Schnellere Ausgabe und geringerer Aufwand
Anthropic veröffentlichte Claude Opus 5.5 am 22. September 2026. Das Unternehmen positioniert das Modell für anspruchsvolle Programmier- und Wissensarbeit. In eigenen Tests nennt Anthropic bei den Standardeinstellungen rund 40 Prozent geringere Kosten für typische Aufgaben gegenüber Opus 5. Dahinter stehen sowohl veränderte Preise als auch eine effizientere Bearbeitung. [4]
Am 28. September 2026 folgte Claude Sonnet 5.5. Hier ist eine präzise Formulierung wichtig: Anthropic spricht von einer mehr als 30 Prozent schnelleren Erzeugung der Ausgabe gegenüber Sonnet 5. Das ist nicht automatisch gleichbedeutend mit 30 Prozent weniger Zeit für jeden vollständigen Arbeitsauftrag. [5]
Die regulären API-Preise von Sonnet 5.5 bleiben laut Veröffentlichung bei 2 US-Dollar je Million Eingabetokens und 10 US-Dollar je Million Ausgabetokens. Weil das Modell für bestimmte Aufgaben weniger Tokens benötigt, nennt Anthropic in eigenen Tests dennoch Einsparungen von bis zu 30 Prozent pro Aufgabe. Gleicher Preis pro Verarbeitungseinheit und geringere Gesamtkosten sind also kein Widerspruch. [5]
GitHub bestätigte die Verfügbarkeit von Sonnet 5.5 in Copilot ebenfalls am 28. September 2026. In den dort beschriebenen frühen Tests wurden Programmieraufgaben mit weniger Schritten, Tokens und Werkzeugaufrufen bearbeitet. Auch das ist eine Untersuchung unter bestimmten Bedingungen, keine allgemeingültige Leistungsgarantie. [11]
Ich würde daraus vor allem eine praktische Konsequenz ziehen: Bei einem Vergleich sollten wir nicht nur die Qualität der ersten Antwort betrachten. Wichtig ist auch, wie viel Arbeit bis zum brauchbaren Ergebnis nötig bleibt.
Google: Eine Milliarde monatliche Nutzer – und neue Verbindungen zu Anwendungen
Google meldete am 11. August 2026, dass die Gemini-App mehr als eine Milliarde monatliche Nutzer erreicht habe. Die Zahl bezieht sich ausdrücklich auf die App und stammt vom Anbieter selbst. Sie sollte nicht mit täglichen Nutzern, zahlenden Kunden oder sämtlichen Nutzern anderer Google-KI-Funktionen gleichgesetzt werden. [6]
Für die praktische Entwicklung ist außerdem interessant, welche Aufgaben innerhalb der Anwendung zusammengeführt werden.
Am 23. September 2026 kündigte Google weitere Connected Apps für Gemini an. Genannt werden unter anderem Verbindungen zu Projekt- und Datenverwaltungsdiensten sowie zu Anwendungen für Gestaltung und Websiteerstellung. Google beschreibt damit einen Arbeitsablauf, bei dem Nutzer weniger zwischen getrennten Anwendungen wechseln müssen. [7]
Darin sehe ich eine wichtige Wettbewerbsfrage: Eine KI kann noch so gute Antworten liefern – wenn sie die benötigten Unterlagen und Werkzeuge nicht erreicht, bleibt ein Teil der Arbeit beim Nutzer.
Das ist allerdings kein Argument, vorsorglich sämtliche Konten zu verbinden. Ich würde für jede Anbindung einen konkreten Zweck festlegen und nur die dafür erforderlichen Zugriffe erlauben.
Gemini 4 Argon: Angekündigt ist nicht automatisch allgemein verfügbar
Am 30. September 2026 stellte Google außerdem Gemini 4 Argon vor. Der angekündigte Schwerpunkt liegt auf komplexen, länger laufenden Aufgaben in Softwareentwicklung, Wissensarbeit und defensiver Cybersicherheit.
Google beschrieb bei der Vorstellung zunächst einen begrenzten Zugang für ausgewählte Cyberverteidiger im Fairwind-Programm. Eine breitere Bereitstellung sollte nach weiteren Prüfungen und Rückmeldungen folgen. Die Ankündigung war damit keine pauschale Freigabe für sämtliche Gemini-Nutzer. [8]
Gerade bei neuen Modellen würde ich deshalb immer zwischen einer Vorstellung, einem begrenzten Testzugang und der tatsächlichen Verfügbarkeit im eigenen Konto unterscheiden.
Was einen Agenten vom gewöhnlichen Chat unterscheidet
Ein Chatbot kann erklären, wie eine Aufgabe erledigt wird. Ein entsprechend ausgestatteter Agent kann zusätzlich Werkzeuge aufrufen, Ergebnisse auswerten und daraus weitere Schritte ableiten.
Bei der Computernutzung kann das über Bildschirmansichten sowie Maus- und Tastaturaktionen geschehen. Anthropic beschreibt diesen Ablauf in seiner Dokumentation: Die Anwendung führt angeforderte Aktionen aus und meldet deren Ergebnisse an das Modell zurück. Das Modell entscheidet anschließend, ob weitere Schritte erforderlich sind. [10]
Ein mögliches Einsatzbeispiel wäre die Vorbereitung eines Kundenangebots:
Anfrage auswerten: Gewünschte Leistungen und fehlende Angaben erfassen.
Unterlagen prüfen: Freigegebene Preislisten und passende Vorlagen heranziehen.
Entwurf erstellen: Positionen zusammenstellen und offene Fragen kennzeichnen.
Ergebnis vorbereiten: Den Entwurf mit nachvollziehbaren Grundlagen zur Prüfung vorlegen.
Das ist ein beispielhafter Soll-Ablauf, kein Bericht über einen bereits getesteten Einsatz bei TNSystem.
Die entscheidende Grenze würde ich vor dem Versand ziehen. Eine Angebotsvorbereitung ist etwas anderes als eine verbindliche Zusage gegenüber dem Kunden. Der Agent müsste wissen, wann seine Aufgabe endet und eine Freigabe erforderlich ist.
Selbstständig arbeiten darf nicht bedeuten, den Auftrag eigenmächtig zu erweitern.
Der Wettbewerb verlagert sich auf vollständige Arbeitsabläufe
OpenAIs Dokumentation aus Ende September beschreibt mit den sogenannten Dots Agenten für längerfristige Aufgaben und angeschlossene Werkzeuge. Die aktuelle Dokumentation nennt eine schrittweise Einführung, abhängig von Produkt, Tarif, Region und administrativer Freigabe. Individuelle Pro-Konten außerhalb des EWR, des Vereinigten Königreichs und der Schweiz werden dabei von weltweit eingeführten Geschäftskonten unterschieden. Ob der Zugang im vorgesehenen Konto besteht, muss deshalb konkret geprüft werden. [2][9]
Zusammen mit den neuen App-Verbindungen bei Gemini und den auf längere Arbeitsabläufe ausgerichteten Claude-Modellen ergibt sich für mich ein erkennbarer Trend: Die Anbieter konkurrieren nicht mehr ausschließlich darum, wer die überzeugendste einzelne Antwort erzeugt. Sie wollen möglichst viel vom Weg zwischen Auftrag und Ergebnis übernehmen.
Für Nutzer kann das bequem sein. Für Entwickler entsteht eine andere Aufgabe: Nicht nur die Modellanfrage muss funktionieren, sondern auch die Verbindung mit Dateien, Benutzerrechten und bestehenden Anwendungen.
Dabei würde ich die Austauschbarkeit im Blick behalten. Wenn ein Arbeitsablauf vollständig von Besonderheiten eines einzelnen Anbieters abhängt, kann ein späterer Wechsel aufwendig werden. Eine sauber abgegrenzte Einbindung wäre mir deshalb lieber als zahlreiche schwer nachvollziehbare Sonderlösungen.
Neue Tarife sind keine neuen Fähigkeiten
OpenAIs Dokumentation nennt Pro 100, Pro 200 und Pro 500. Das sind Tarifbezeichnungen, keine Modellgenerationen. Nutzungskontingente und Verarbeitungsklassen müssen im jeweiligen aktuellen Tarif geprüft werden; sie sagen noch nichts darüber aus, ob eine bestimmte Anwendung angebunden werden kann. [9]
Für eine Entscheidung würde ich deshalb drei Ebenen trennen: das verwendete Modell, die tatsächlich verfügbaren Werkzeuge und den gebuchten Nutzungsumfang.
Ein größeres Kontingent löst beispielsweise nicht das Problem, dass eine benötigte Anwendung gar nicht angebunden ist. Ebenso wenig garantiert eine schnellere Ausgabe, dass eine schwierige Aufgabe korrekt gelöst wird.
Bei einem betrieblichen Test würde ich die Gesamtrechnung betrachten: laufende Nutzung, Einrichtung, Kontrolle und mögliche Nacharbeit. Der niedrigste Preis pro Token muss nicht zum günstigsten brauchbaren Ergebnis führen.
Umgekehrt braucht eine klar begrenzte Routineaufgabe nicht zwangsläufig das teuerste verfügbare Modell.
Leistungsangaben richtig lesen
Die Veröffentlichungen enthalten zahlreiche Testwerte. Sie helfen dabei, Fortschritte einzuordnen, müssen aber zusammen mit ihren Bedingungen gelesen werden.
Ergebnisse aus Forschungsumgebungen oder der API sind nicht automatisch auf den Arbeitsalltag übertragbar. Werkzeuge, Einstellungen und Systemanweisungen können die Resultate beeinflussen. Anthropic merkt bei Opus 5.5 selbst an, dass kleine Unterschiede zwischen hohen Benchmarkwerten die tatsächlichen Unterschiede im Alltag nicht immer zuverlässig abbilden. [4]
Ich würde deshalb keinen Anbieter allein aufgrund eines einzelnen Balkendiagramms zum allgemeinen Sieger erklären.
Für den eigenen Betrieb wäre ein Vergleich mit bekannten Aufgaben aussagekräftiger: dieselben Unterlagen, dieselbe Anforderung und ein vorher festgelegtes Prüfschema. Danach lässt sich beurteilen, welche Lösung vollständiger arbeitet, weniger Nachfragen benötigt und ihre Ergebnisse nachvollziehbar begründet.
Auch Nutzerzahlen sind eine andere Messgröße als fachliche Zuverlässigkeit. Eine große Reichweite belegt nicht, dass ein Modell jede Spezialaufgabe besser löst.
Mehr Handlungsmöglichkeiten brauchen engere Grenzen
Ein fehlerhafter Text lässt sich vor der Verwendung korrigieren. Eine bereits versendete Nachricht, gelöschte Datei oder veränderte Konfiguration kann deutlich schwerer zurückzunehmen sein.
Anthropic warnt in seiner Dokumentation zur Computernutzung ausdrücklich vor zusätzlichen Risiken. Dazu gehört Prompt Injection: Inhalte einer Website oder eines Dokuments können Anweisungen enthalten, die einen Agenten vom eigentlichen Auftrag abbringen sollen. Der Anbieter empfiehlt unter anderem getrennte Arbeitsumgebungen, minimale Rechte, begrenzten Internetzugriff und menschliche Bestätigung bei folgenreichen Handlungen. Solche Maßnahmen senken Risiken, beseitigen sie aber nicht. [10]
Für einen ersten betrieblichen Einsatz würde ich daher eine Testumgebung mit geeigneten Beispieldaten vorsehen. Der Agent bekommt nur die Zugriffe, die für den vereinbarten Versuch nötig sind.
Außerdem müssten Aktionen nachvollziehbar bleiben. Welche Datei wurde gelesen? Welche Änderung wurde vorgenommen? Worauf beruht die Behauptung, eine Aufgabe sei abgeschlossen?
Ein Agent sollte nicht nur einen überzeugenden Abschlussbericht schreiben. Sein Ergebnis muss sich an den tatsächlichen Dateien, Änderungen oder ausgeführten Tests überprüfen lassen.
Bei Unsicherheit erwarte ich eine Rückfrage oder einen klaren Abbruch. Ein System, das stillschweigend eine fehlende Information erfindet, würde ich nicht als selbstständig, sondern als unzuverlässig bewerten.
Wie ich mit der neuen Generation beginnen würde
Ich würde nicht versuchen, sofort einen vollständigen Betrieb zu automatisieren. Ein klar begrenzter Vorgang wäre der bessere Anfang.
Geeignet wäre beispielsweise eine wiederkehrende Auswertung mit freigegebenen Daten, eine Dokumentenvorbereitung oder eine kleine Softwareänderung in einer getrennten Entwicklungsumgebung.
Vor dem Versuch würde ich festhalten, wie ein korrektes Ergebnis aussieht. Danach werden nicht nur Geschwindigkeit und Formulierung bewertet, sondern Vollständigkeit, Fehler, Nacharbeit und die Einhaltung der gesetzten Grenzen.
Eine zusätzliche Prüfung wäre mir besonders wichtig: Was geschieht, wenn Unterlagen fehlen, ein Werkzeug nicht erreichbar ist oder zwei Angaben einander widersprechen? Gerade solche Fälle zeigen, ob der Arbeitsablauf im Alltag tragfähig ist.
Erst nach mehreren nachvollziehbar erfolgreichen Durchläufen würde ich den Umfang erweitern. Das ist weniger spektakulär als eine Vorführung mit weitreichenden Zugriffsrechten. Dafür lässt sich genauer erkennen, wo tatsächlich ein Nutzen entsteht.
Mein Fazit: Der Fortschritt liegt zwischen Auftrag und Ergebnis
Die Veröffentlichungen aus Spätsommer und Herbst 2026 bringen belegbare Neuerungen: weitere GPT-6-Modelle, Claude 5.5, zusätzliche Anwendungsschnittstellen und neue Ansätze für länger laufende Agentenaufgaben. Die Richtung ist klar erkennbar. Eine pauschale Behauptung, damit seien sämtliche Arbeitsabläufe bereits revolutioniert, wäre mir trotzdem zu weitgehend. [1][2][4][5][7]
Mich überzeugt eine neue Modellgeneration dann, wenn sie bei einer konkreten Aufgabe weniger unnötige Arbeit hinterlässt. Wenn Ergebnisse überprüfbar sind, Grenzen eingehalten werden und der Mensch nicht ständig versteckte Fehler suchen muss, entsteht echte Entlastung.
Der klassische Chat wird dadurch nicht überflüssig. Für viele Fragen reicht weiterhin eine gute Antwort. Wo mehrere Anwendungen und Arbeitsschritte zusammenkommen, können Agenten jedoch die interessantere Form der Unterstützung sein.
Die wichtigste Frage lautet für mich nicht, wie viel eine KI selbstständig erledigen kann. Sondern wie verlässlich sie das erledigt, was wir ihr bewusst übertragen haben.
Einordnung und Recherche
Recherchestand: 11. Oktober 2026. Leistungs-, Kosten- und Nutzerangaben stammen aus Veröffentlichungen der Anbieter und wurden nicht in einem eigenen Vergleichstest überprüft. Preise und Verfügbarkeit können sich ändern und je nach Konto, Region, Kontextlänge oder Tarif unterscheiden. Der Beitrag dient der allgemeinen technischen Orientierung, nicht der individuellen Rechts- oder Beschaffungsberatung.
Quellen und weiterführende Informationen
[1] OpenAI: API-Changelog – GPT-6-Veröffentlichungen
Quelle lesen ↗
[2] OpenAI: Neuerungen 28. September bis 2. Oktober 2026
Quelle lesen ↗
[4] Anthropic: Introducing Claude Opus 5.5
Quelle lesen ↗
[5] Anthropic: Introducing Claude Sonnet 5.5
Quelle lesen ↗
[6] Google: Eine Milliarde monatliche Gemini-App-Nutzer
Quelle lesen ↗
[7] Google: Neue Connected Apps für Gemini
Quelle lesen ↗
[8] Google: Gemini 4 Argon und begrenzter Zugang
Quelle lesen ↗
[9] OpenAI: Dots – Tarife und regionale Verfügbarkeit
Quelle lesen ↗
[10] Anthropic: Computer Use und Schutzmaßnahmen
Quelle lesen ↗
[11] GitHub: Claude Sonnet 5.5 in Copilot
Quelle lesen ↗
[12] OpenAI: API-Preise und Verarbeitungsklassen
Quelle lesen ↗